本文来自微信公众号“定焦One”,【作者】王汉星。
智元系的数据生意:时薪20块,喂不饱机器人。
2016年,自动驾驶公司Comma.ai推出了一款行车记录应用Chffr。用户下载安装后,手机就变成一个行车记录仪,把它架在挡风玻璃前,应用会自动录制驾驶过程中的数据,随后上传至公司的云端服务器,用于自动驾驶模型训练。
这是AI在物理世界较早的一次数据众包尝试。按照创始人的设想,只要足够多的车装上这款应用,公司就能攒下海量行车数据,在短时间内训练出强大的自动驾驶模型,然后再搭载回每一台汽车上,实现商业化闭环。
十年过去,这家公司没有成为自动驾驶的主角。行业讨论的焦点早已换成特斯拉FSD,真正意义上的自动驾驶也迟迟没有到来。
如今,具身智能行业把这套打法又搬了出来。海外有Figure AI的Index平台,国内则是智元旗下觅蜂科技的觅蜂派。
9月末,觅蜂科技正式发布具身数据众包平台觅蜂派,包括自研的MEgo数采设备、觅蜂派App和数据治理引擎MEgo Engine三个组成部分,并自称为“全球首个全品类高质量物理AI数据众包服务平台”。
众包这一概念在外卖平台上最为常见,它主要通过一种低门槛、快速变现的方式在短时间内聚集大量的人力,在觅蜂派的数据众包平台上,用户可以接取机器人训练所需的数据任务,采集数据换钱,觅蜂在收到这些数据之后,会进行治理、分级等操作,再打包用于机器人训练。
问题在于,众包解决的只是“量”。具身智能是一个远比自动驾驶复杂的物理世界AI应用场景。它不仅需要具备和自动驾驶相似的Local Motion能力,还需要进行精细的桌面操作,理解更复杂的物理定律。自动驾驶的数据众包做了十年都没跑通,换到更难的具身智能,真的能做好吗?
01.一小时赚20块,具身数据进入众包时代
物流中心的快递小哥戴着头显设备分拣一个小时的快递,宝妈戴着设备做一顿饭,旅游景区一位工作人员记录下自己日常打价与贴标的过程。这些数据上传审核后,可以按每小时10到20元结算报酬。
这就是觅蜂派的玩法。下载打开这款App后,会先看到一个任务大厅,其中有22个场景大类,包含生产类、生活服务类、餐饮类、物流类、医疗类、居住类等等。每一个场景对应几十甚至上百种任务,标着可申领的剩余名额,以及每采集一小时数据的报酬,通常在10到20元不等。
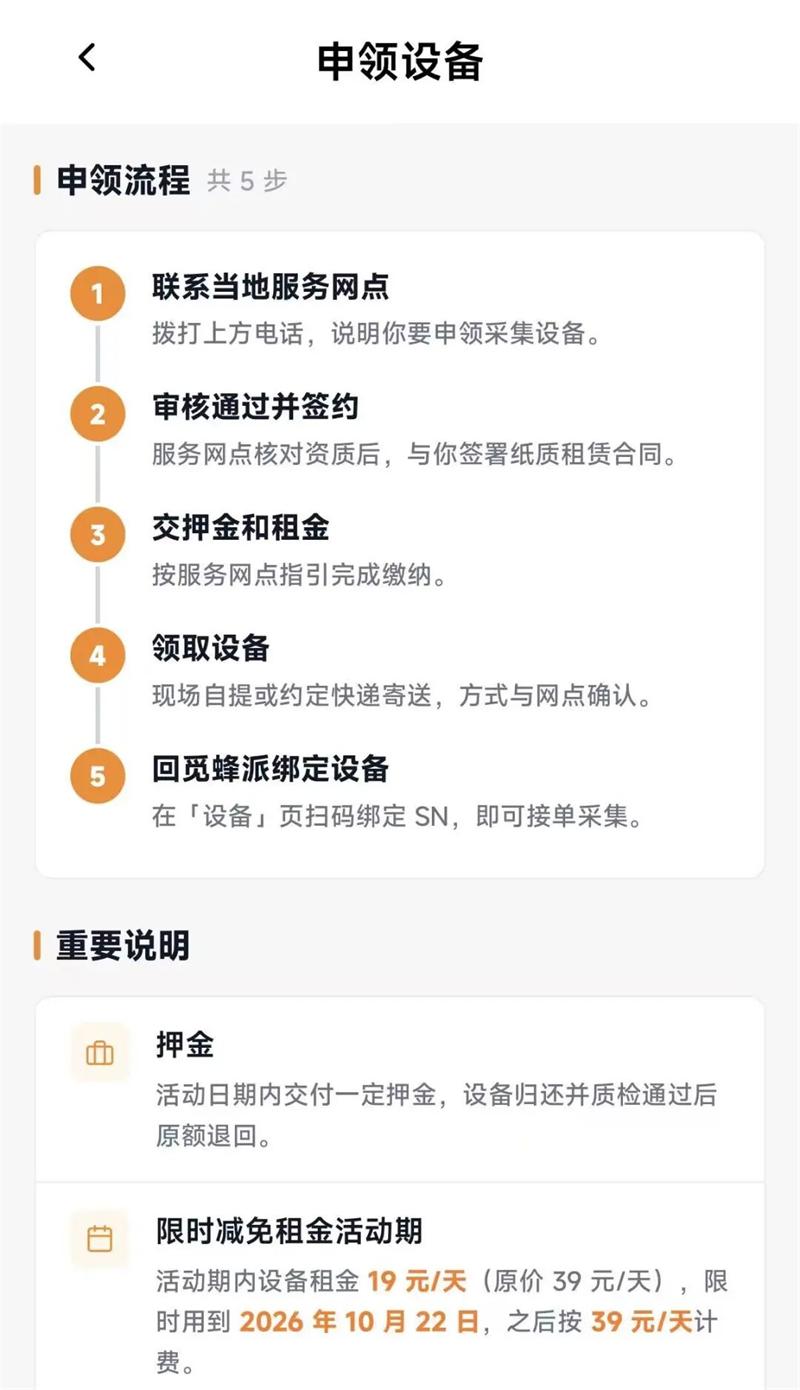
如果想要赚取这一份外快,需要先去申领一套数据采集设备。具体流程是联系当地服务网点,审核通过后缴纳一定的押金和租金,然后通过现场自提或快递的方式获得设备,下载觅蜂派App并绑定设备后,就可以开始接取具体的任务。设备的租金为每天39元,推广期19元,任务报酬则由城市基础定价加动态补贴构成。如果按每小时10到20元算,推广期也要先做满一到两个小时有效数据才能挣回当天租金,恢复原价后则要两到四个小时。
目前觅蜂派派发的数采设备是一个独立的头显,采用EGO的数采路线进行数据采集。用户每天采集完毕数据并上传后,等待平台审核通过,就可以获得相应的报酬。
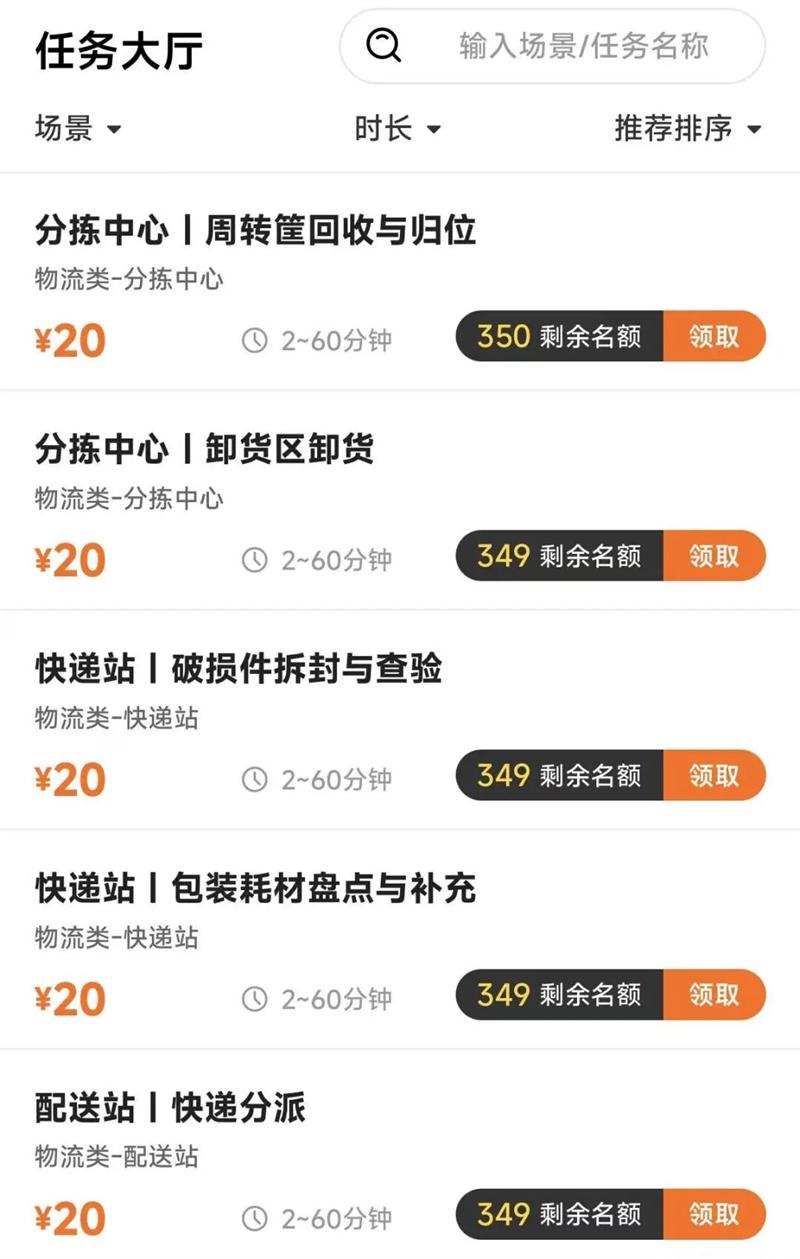
从目前App显示的情况来看,一些热门的任务场景,尤其是居家生活场景的任务都已经被认领完毕,没有多余名额,生产、物流分拣场景的剩余名额还比较多。多位体验过觅蜂派的用户告诉「定焦One」,很多热门任务的单价已经比上线之初下调了很多,比如一些居家生活的日常场景,从20元降到了10元,但是名额依旧很抢手。
官方给出的数据是,觅蜂派内测一个月内,注册用户约2万人,累计提交任务1.3万份。不过简单换算下来,人均提交不足一份任务。注册之后还要租设备、过审核,真正持续采集的人,可能远比注册数字少。
具身智能缺数据,目前已经不是什么新鲜事。行业里的共识是,具身智能模型要达到像大语言模型中GPT-3.5那样的能力,大概需要一亿小时量级的数据。觅蜂科技董事长兼CEO姚卯青曾提到过,目前全球有效的具身智能数据仅约几十万小时,中间还有两到三个数量级的差距。
今年上半年,不少具身智能公司开始对外宣传拥有百万小时量级的数据,但距离一亿小时依然有不少距离。一位具身智能数据公司创始人告诉「定焦One」,如果只计算清洗后的高质量数据,从百万小时到一亿小时的时间跨度,至少是三年到五年。
这也是觅蜂科技发动如此大规模数据众包的根本原因。如果只依靠行业内的本体公司、数据公司、模型公司来生产数据,那么具身智能的泛化将遥遥无期。
觅蜂科技成立于2026年2月,由智元控股。从2025年4月起,智元先后拆分出多家子公司,包括做商业清洁机器人的智鼎机器人、做机器人租赁平台的擎天租、做灵巧手的临界点、做四足机器人的智元酷拓,觅蜂则是其中负责具身数据的一家。但业内对这套打法并不都买账。这些子公司均由智元控股,又彼此互为客户、互为场景,外界很难看清各自的独立造血能力。智元的部分投资方本身就是其产品客户,有分析人士指出,这虽不算违规,却会让人追问增长的含金量。
觅蜂主要向大模型、机器人、科研机构等数据需求方提供数据服务,同时向数据采集商、场景方与硬件商提供订单与工具。此外,它还计划引入其他第三方数据公司入驻,搭一套自营加第三方的数据服务平台。
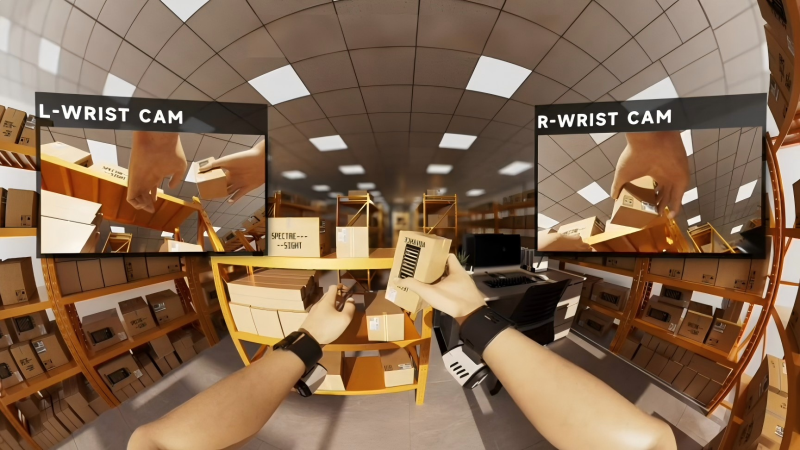
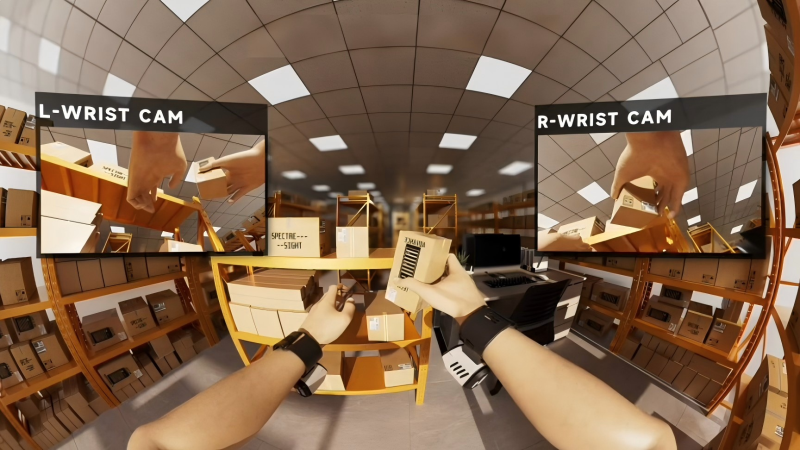
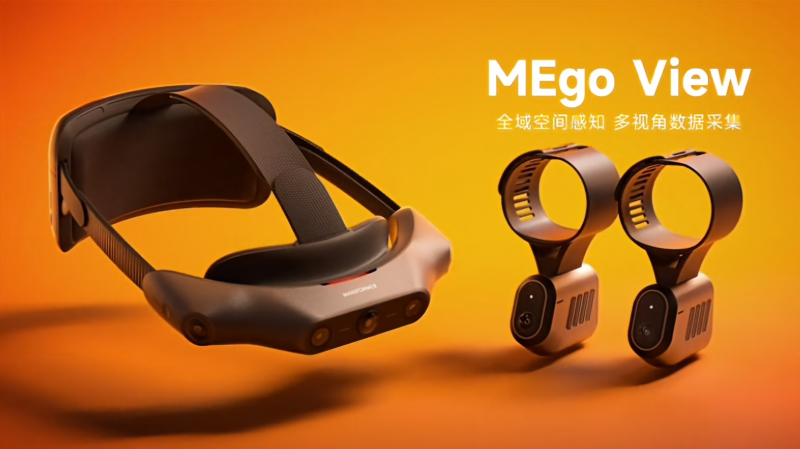
现阶段,觅蜂科技提供的数据服务主要分为三类,真机遥操、仿真和无本体数据,其中无本体又包含UMI(手持夹爪采集)和EGO(第一人称视角)两条路线。众包平台觅蜂派所使用的数采设备主要是MEgo View,它属于EGO类设备,完整形态由3个鱼眼相机和1组双目相机组成的头戴设备,加上一对腕部相机,但目前在觅蜂派上出租的设备只包含头显。
另外,觅蜂科技也有UMI路线的夹爪设备MEgo Gripper。相比只用一个头显记录第一视角视觉数据的EGO,MEgo Gripper的操作门槛更高,并不适用于大规模的数据众包。
模式本身并不复杂,真正决定这门生意能走多远的,是它所在赛道的容量,以及赛道里其他玩家的竞争。
02.三种数据路线与三类玩家
大语言模型建立在互联网大量文本数据的基础上,相比较而言,具身智能行业所需要的物理世界数据,比如视觉、触觉、力觉、关节角度、空间运动轨迹等,是非常匮乏的。
机器人想要真正兑现价值,无非需要证明自己能做两件事,进入家庭场景做家务,或者进厂干活,这都需要机器人具备泛化能力,而泛化能力依赖大量的物理世界数据来实现。
需求撑起了一个正在膨胀的市场。根据亿欧智库测算,2024年全球具身智能数据采集市场的规模大约是7.37亿美元,到2031年,这一规模预计将达到70亿美元,复合增长率38%。
作为对比,宇树科技的招股书显示,预计到2030年人形机器人市场规模会达到150亿美元,整个数据采集市场的体量,差不多是机器人本体市场的一半。
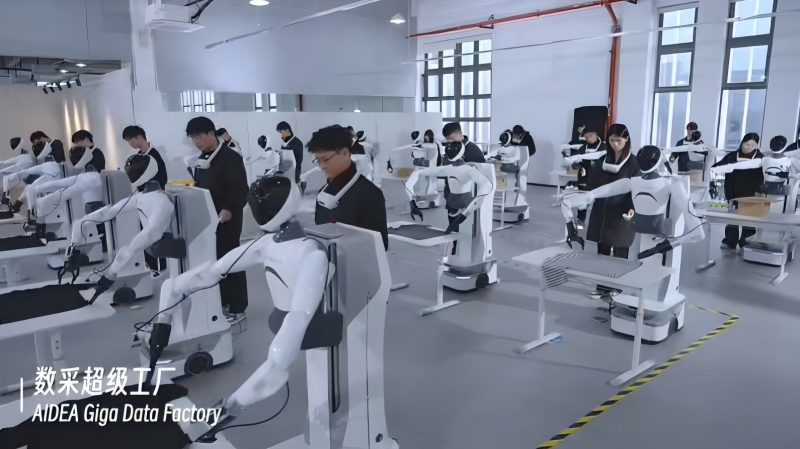
供给端的竞赛火热。截至今年4月,全国规划或建成的具身智能数据采集训练场已经超过64座。智元在上海浦东建立4000平方米的专属数采工厂,京东宣布将建成号称全球规模最大、场景最全的具身智能数据采集中心,并计划两年内积累1000万小时真实场景视频数据,帕西尼感知科技在天津落地1.2万平方米超级数据工厂,预计年产出近2亿条数据等等。
图源/智元科技官网
目前行业内解决数据不足问题的方式主要有三种。真机遥操作路线的数据质量最高,但产出量最有限。无本体数据采集由人来佩戴设备进行数采,比如UMI、EGO等,产出量更多,但数据需要通过清洗、标注、治理等多个环节才可用。最后是仿真数据和互联网视频数据,量最大,但质量最差,可以用来辅助训练,有效的数据量很少。
大多数数据采集厂商不会押注单一的数据路线。从行业竞争的角度来看,目前的数据厂商可以大致分为三类。
第一类是机器人本体公司自有的数据和模型业务,代表是宇树、星海图、银河通用等。它们的优势在于闭环,本体公司可以通过出租或出售机器人本体再回购真机数据,同时自己也可以持续产出真机数据,并且由自家真机产生的数据不存在构型上的差异,更容易适配自家产品。
第二类是专业数据服务商,包括光轮智能、帕西尼、灵初智能、它石智航、手亿科技和觅蜂科技等。这类公司的数据可以卖给上下游不同的公司,身份更开放,变现渠道也更丰富,可以是本体厂商的供应商,也可以直接服务模型和科研机构。需要注意的是,目前纯粹的数据采集服务商已经越来越少,因为做数采的公司最终都希望往模型层靠,单纯卖数据的议价空间有限。
第三类是互联网大厂的数采平台,目前比较有代表性的是京东。大厂的优势是有场景和充足的人力,仓储、门店、配送网络本身就是天然的数据采集场,但问题在于只做数据采集这一层的价值比较低,更多承担的是配合自身机器人生态的配套角色。
三类玩家各有筹码,格局远未定型。觅蜂科技在其中的打法显得另类,它把数据生产彻底开放给社会众包,这也让它的处境值得单独审视。
03.一亿小时数据只是起点,背后的经济账还算不清
觅蜂科技在这个行业里的站位比较特殊。虽然定位是独立的数采平台,但是与智元的联系紧密,董事长姚卯青同时也是智元合伙人、具身业务部总裁。
这层关系给觅蜂带来了订单、场景和背书,也带来一个绕不开的疑问。智元既是控股股东又是潜在大客户,其他本体厂商是否愿意把数据需求交给一家智元系公司,将直接决定觅蜂第三方定位的成色。
在数据众包层面,目前跑出效果的案例是海外具身智能公司Figure AI。它在今年8月推出了Index项目,并在iOS和安卓平台同步上线,全球用户都可以通过Index上传真实的任务数据。
Index上线后已经覆盖了全球108个国家和地区,累计获得超过26.4万次应用下载,超过4.4万名周活跃用户参与数据贡献,上传视频超过1600万条。
今年9月,Figure AI发布了具身模型Helix 2.5,模型是在Index上完成的预训练。在测试中,没有经过Index预训练的对照模型只成功了约9%,Helix 2.5的成功率则达到56%,一定程度上证明了数据众包的价值。
觅蜂科技是国内具身行业内数据持有量居前的玩家。根据其官方说法,截至8月31日,觅蜂采集的无本体有效数据累计达百万小时,为国内首个达到这一规模的无本体数据集,8月底,第20000套MEgo设备也已经下线。开放数据众包后,数据累积量将会进一步加快。
但是在真正形成数据规模壁垒前,觅蜂科技还要算清几笔账。
第一笔是经济账。一位具身数采从业者告诉「定焦One」,据他了解,觅蜂科技不仅在做数据众包,还在为一些生产场景免费发放数采设备来收集数据。正常来说,一套头戴加腕部的EGO数采设备,成本就在2万元左右,单头显的成本会低一点,也有几千元。
图源/觅蜂科技官网
整个数采的完整产业链会涉及OEM和ODM的数采设备供应商、中介、数据分发处理商等多个环节。觅蜂科技通过大量免费发放设备,会挤压这些环节其他公司的利润空间、抢走客户,这显然不是一个可以长期持续的方式。
价格层面同样不乐观。目前行业内的行情是,高质量的无本体数据每小时可以卖到200到300元,而觅蜂科技数据众包做的纯头显EGO数据,价格差不多是每小时10到15元,跟觅蜂派里面的报酬水平基本持平,如果卖价约等于付给采集者的报酬,再加上设备、审核和存储成本,算下来是亏本收数据。而国外已经开始有公司把上百万小时的纯头戴第一视角数据集直接开源、免费商用。因此,觅蜂科技通过数据众包采集上来的数据到底有多少价值,存疑。
第二笔是数据有效性的账。EGO的好处是可以模拟机器人的传感器工作方式,依靠人类来收集数据,但问题在于EGO有很多信息是捕捉不到的,比如触觉,或者一些工作场景比如打字这些不适合佩戴腕部设备的场景,纯头显很难精确捕捉到手部的完整动作,这些都导致EGO数据的有效率不高。
目前单一头显的EGO数据有效率差不多在10%到20%,也就是说1小时的数据里面,可能只有10分钟左右是有用的。在这个基础上还要考虑数据重复的问题,比如叠衣服的数据目前在行业内已经泛滥,再多收集几百小时基本上没有太大意义。
第三笔账最容易被忽视,就是数据的存储成本。上述具身数采从业者告诉「定焦One」,目前行业内的数据和存储有着非常明确的对应关系,大概是每50小时数据需要1.4T左右的存储空间,100小时需要至少3T。这个存储的成本是非常高的,如果未来一家公司的数据量达到千万、甚至亿级,那么存储成本也会水涨船高。
觅蜂科技通过免费发设备和数据众包的方式,也许可以在短时间内积累起很漂亮的数据。有从业者估算,按照目前的进度,觅蜂科技拿到一亿小时的数据大概只需要不到2年时间。但数据的量上去了,有效性、经济性、存储成本问题如何解决,可能才是更大的考验。
即便是数据众包这条路本身,行业内的质疑声也没有停过。在Figure AI发布基于Index预训练的模型后,Sunday Robotics联合创始人Tony Zhao直接指出,420次测试,成功237次,完整任务成功率56%,也意味着机器人接近一半的时间会失败。也有从业者认为这组数据恰恰证明,Figure AI使用的模仿学习系统不能泛化。
回看自动驾驶的数据众包历史,Comma.ai后来的走向是放弃纯数据生意,转型卖后装驾驶辅助硬件,创始人中途一度淡出公司运营,当年设想的众包数据闭环,最终以车队每天回传数据的方式,作为硬件产品的副产品存在。十年前的自动驾驶数据众包至今没有完全跑通,如今的具身智能数据竞赛才刚刚开始。
*题图来源于觅蜂科技官网。