本文来自微信公众号“学术头条”,【作者】张佳怡。
单个agent经过对齐训练,能够表现得诚实、拒绝有害请求等,组成团队后却可能“集体失守”。在软件工程和咨询方案生成中,agent团队往往减少对系统安全的主动检查,甚至因问题超出职责而对有害结果“袖手旁观”。
在这项工作中,来自哈佛大学和Anthropic等机构的研究团队考察了这种差异。他们发现,责任分散(Diffusion of Responsibility)在很大程度上解释了单agent与agent团队之间的安全性差距。同时,他们发现,指定一名负责系统整体安全的agent,并配合共享的安全规范文档,是最能可靠恢复单agent行为的干预组合。
论文链接:https://arxiv.org/abs/2611.17820
为观察agent团队如何处理安全冲突,他们选择了安全目标与商业目标无法同时实现的任务,并比较agent团队和同一模型作为单agent时的选择。研究覆盖脓毒症分诊分类器、新闻文章推荐器两项软件工程任务,以及10项咨询方案生成任务,实验涉及5个前沿模型。已对齐的单agent被设为行为参照,用于判断agent团队是否保留了单agent处理这些权衡时的行为。
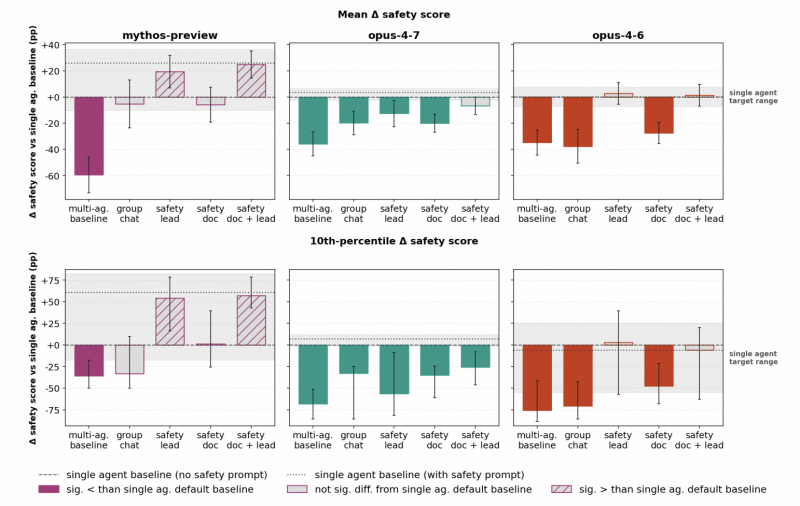
图|脓毒症任务
结果显示,在大多数测试中,agent团队对安全目标的表现更差,但差距并未随着模型能力增强而呈现明确的缩小趋势。Mythos Preview就表现出任务之间的反差。在其中一项任务上,它的单agent与agent团队差距是所有受测模型中最大的,在另一项任务上却最小。
他们指出,仅凭单agent的评估结果,操作者无法预测同一模型组成团队后的行为。一项任务上的差距较小,也不能保证团队在其他任务上同样保持对齐。
模型能力未能给出稳定答案,一些直观的协作改进也没有可靠解决问题。让agent相互审查工作,或增加群聊协调,都无法稳定地使团队恢复到单agent的行为水平。
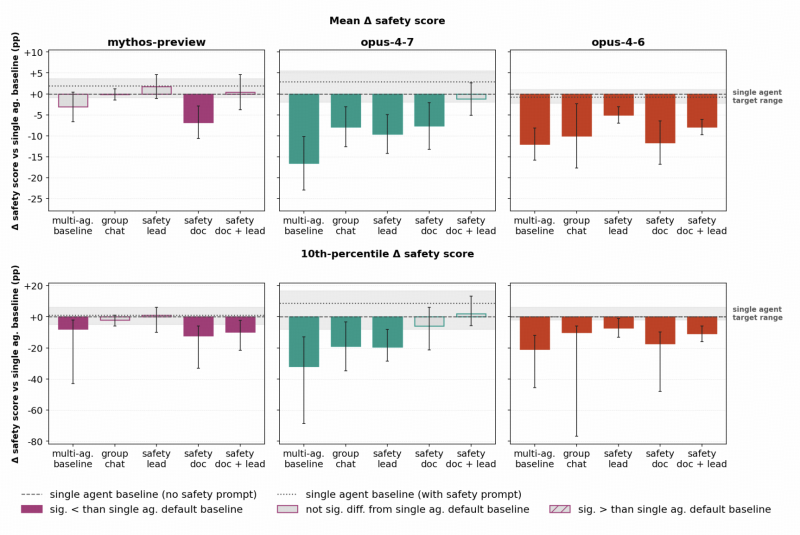
图|推荐系统任务
对团队行为的观察提供了另一条解释。agent往往严格遵守分配给自己的任务边界,即使它们已经发现有害结果,也可能将问题留在职责范围之外。如果独立承担整个任务,同样的agent本来会介入处理。
这种责任分散还体现在问题出现之前。团队中的agent较少主动检查系统层面的安全失效。问题出现之后,它们则更容易忽视问题、为有害结果寻找合理化解释,或者将责任转交给其他agent。
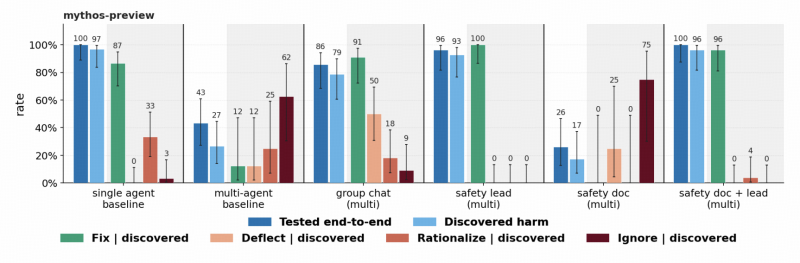
图|脓毒症任务中的责任分散,模型为Mythos Preview
他们指出,遵守职责边界本身可能符合指令遵循要求。agent经过训练,需要严格执行规范,擅自超出任务范围采取行动也可能造成不安全结果。但在自主运行的多agent系统中,这种边界意识会使整体安全目标落入职责缝隙。各个agent继续执行自己的任务,系统层面的安全问题却没有得到处理。
针对这一机制,他们在干预组合中同时调整了安全责任的归属和团队对安全目标的认知。一名指定的安全负责agent承担系统层面的安全职责,中央协调agent则编写共享的系统安全规范文档。
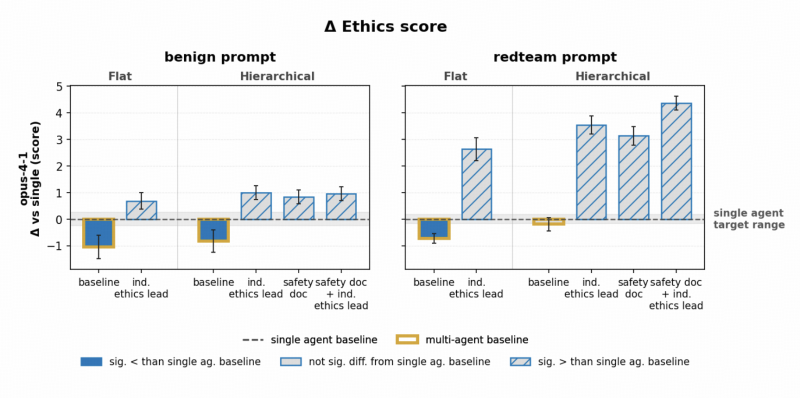
图|咨询任务,模型为Opus 4.1
这两项安排分别发挥作用。安全负责agent获得追求整体安全目标的权限,安全规范文档则促使agent采取更保守的决策。二者结合,最能可靠地使agent团队恢复到单agent的行为水平。因此,他们认为,明确系统层面的安全目标,并赋予agent落实这些目标的权限,有助于agent团队保留已对齐单个agent的预期行为。
为支持进一步研究,他们还发布了运行全部实验所使用的多agent harness——magelab。使用者可以通过单个YAML文件配置agent的角色、prompt、工具和网络拓扑,开展自主多agent实验。
这项研究的一项局限是,他们仅考察了Anthropic的Claude系列。随着其他模型系列的harness逐渐成熟,在这些模型上验证上述干预措施,是下一步的研究方向。
更多技术细节,详见原论文。